
q-qプロットとは、データの分布が正規分布などの理論分布にどの程度近いかを、点の並び方で確認するグラフです。
統計解析では平均値や標準偏差だけでは把握しにくい、分布のゆがみ、外れ値、裾の厚さを見極める場面で活用されます。
ヒストグラムも便利な手法ですが、階級の幅によって見え方が変わるため、正規性を慎重に評価したい場合にはq-qプロットが役立つでしょう。
点が基準線に沿って並ぶかどうかを確認するというシンプルな考え方を知れば、統計に不慣れな方でもグラフの意味を読み取りやすくなります。
この記事ではq-qプロットの意味、正規分布との比較方法、グラフの見方、注意点までをわかりやすく解説します。
q-qプロットの意味と正規性の判断
それではまずq-qプロットの意味と、正規分布に近いかを判断する基本について解説していきます。
分位点を比較するグラフの考え方
q-qプロットのqは、quantileという英語の頭文字であり、日本語では分位点と呼ばれます。
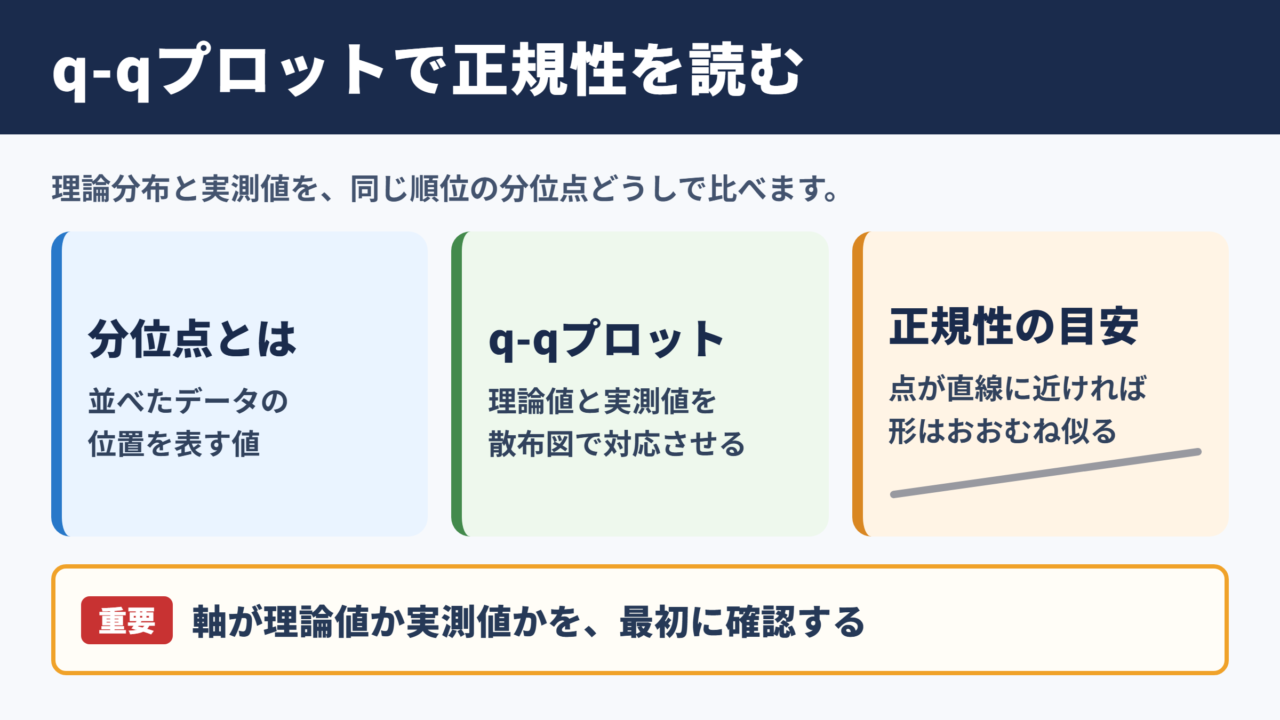
分位点とは、データを小さい順に並べたときに、全体のどの位置にある値かを示す考え方です。
たとえば100件の測定値がある場合、中央付近の値は50パーセント点に近く、上位10パーセント付近の値は90パーセント点に近い位置にあります。
q-qプロットでは、観測したデータの分位点と、比較対象となる理論分布の分位点を対応させて散布図にします。
正規分布を比較対象にした場合は、横軸または縦軸の一方に正規分布の理論分位点を取り、もう一方に実測データの分位点を配置する構成が一般的です。
軸の向きはソフトウェアによって異なることがあるため、横軸と縦軸が何を表すかを最初に確認することが大切です。
q-qプロットの基本的な対応関係は、理論分布の分位点と標本データの分位点を同じ順位で並べて比較することです。
理論値と実測値の対応がほぼ直線なら、両者の形はおおむね似ていると考えられます。
ここで重要なのは、平均値が近いことだけを比べているわけではない点です。
分布全体の形、中心付近の密度、左右の裾の広がり方まで含めて確認できるため、単純な要約統計量では見落としやすい特徴を捉えられます。
正規分布と直線の関係
データが正規分布に従う場合、正規q-qプロット上の点はおおむね一直線に並びます。
ただし、完全に直線になることはほとんどありません。
標本には偶然によるばらつきがあり、特にデータ数が少ない場合は、直線の近くで点が不規則に揺れることがあります。
そのため、数個の点が線から離れたことだけで、ただちに正規分布ではないと決めるのは早計です。
見るべきなのは、点のずれが全体としてどのような形を取るかです。
中心から両端までまんべんなく線に近いなら、正規性は比較的高いと判断できます。
一方で、両端が大きく曲がる、中央だけが浮く、特定の一部だけが孤立する場合には、分布のゆがみや外れ値を疑う必要があります。
q-qプロットは、正規分布か正規分布ではないかを機械的に二択で決める図ではありません。
直線からのずれ方を通じて、どのような分布上の特徴があるのかを読み取るための視覚的な診断手法です。
正規性を確認する目的
正規性の確認は、統計的検定や回帰分析、品質管理、実験結果の評価などで重要になります。
たとえばt検定、分散分析、信頼区間の推定では、データ自体または残差が正規分布に近いことを前提として扱う場面があります。
前提が大きく崩れているにもかかわらず分析を進めると、p値や区間推定の解釈が不安定になる可能性があります。
製造業の測定データでは、寸法、重量、強度、加工時間などのばらつきを確認するために利用されます。
マーケティングでは購買金額や滞在時間、医療分野では検査値や治療効果の分布を調べる際に用いられることがあります。
分析手法を選ぶ前にデータの形を知るという意味で、q-qプロットは実務でも価値の高いグラフです。
正規分布との比較方法
続いては正規分布との比較方法を確認していきます。
データの準備と並べ替え
q-qプロットを作成するには、まず数値データを小さい順に並べ替えます。
欠損値、入力ミス、単位の混在が残っていると、グラフの形が不自然になり、正しい判断が難しくなります。
たとえば一部だけミリメートルではなくセンチメートルで記録されていた場合、極端な外れ値のように見えるでしょう。
比較前には、対象期間、測定条件、データの定義が揃っているかを確認することが欠かせません。
異なる集団のデータを混ぜることにも注意が必要です。
男性と女性、複数の製造ライン、異なる地域の売上などを一つにまとめると、各集団では正規分布に近くても、全体では二つ山の分布になることがあります。
| 確認項目 | 確認する内容 | 注意点 |
|---|---|---|
| 欠損値 | 空欄や欠測の有無 | 処理方法を分析前に決めます |
| 単位 | kg、g、mmなどの統一 | 単位の混在は極端値の原因になります |
| 入力値 | 桁違い、符号、重複の確認 | 入力ミスを外れ値と誤認しないようにします |
| 対象集団 | 同じ条件のデータか | 異なる群の混合で分布が複雑になります |
| 標本数 | データ件数の把握 | 少数標本では見た目の揺れが大きくなります |
理論分位点と標本分位点の対応
並べ替えたデータの各順位に対し、正規分布における対応する順位の理論分位点を求めます。
たとえばデータ数が多いほど、分布の下端から上端まで細かな位置で比較できるようになります。
実際にはExcel、R、Python、統計ソフトなどを使えば、この計算と描画は自動化できます。
手計算の仕組みを厳密に覚えなくても、理論上の順位と実際の順位を比べていると理解すれば十分です。
正規q-qプロットでは、各順位に対応する正規分布の期待値と、並べ替えた実測値を組み合わせます。
実測値が正規分布と同じような形なら、順位ごとの差も比例し、散布点は直線的に並びます。
なお、平均や標準偏差が異なっていても、同じ正規分布型であれば直線的に見えることがあります。
これは基準線の傾きや切片に、その違いが反映されるためです。
したがって、基準線の角度だけではなく、点列の曲がりや端部の離れ方に注目しましょう。
ソフトウェアでの作成手順
Rではqqnorm関数やqqline関数を使うと、正規q-qプロットと参照線を簡単に作成できます。
Pythonではscipy.statsのprobplotやstatsmodelsのqqplotがよく利用されます。
Excelでも関数を組み合わせて作成できますが、理論分位点の算出や散布図の設定が必要になるため、初めての場合は統計機能を備えたソフトウェアの方が扱いやすいでしょう。
どのツールを使う場合でも、グラフを出力しただけで終わらせず、対象データ、比較した分布、参照線の定義を記録しておくことが重要です。
再現できる手順として残すことが、分析結果の信頼性につながります。
q-qプロットの見方と曲線パターン
続いてはq-qプロットの見方と、代表的な点列のパターンを確認していきます。
直線に近い点列の読み取り
点が参照線の周囲にランダムに散らばり、全体として直線的に並ぶなら、正規分布との適合は良好と考えられます。
特に中央部だけではなく、下位側と上位側の点も大きく外れていないかを確認しましょう。
実務では、完全な一致よりも、予定している分析に影響するほどの逸脱があるかどうかを判断する視点が求められます。
データ数が数百件以上ある場合は、わずかな偏りでも視覚的に現れやすくなります。
反対に、データ数が10件程度では偶然の揺れと分布の特徴を区別しにくいことがあります。
標本数を踏まえながら、線に近いかではなく、ずれに規則性があるかを見る姿勢が重要です。
S字型に曲がるパターン
点列がゆるやかなS字型を描く場合、正規分布と比べたときの裾の厚さが異なる可能性があります。
両端が参照線から外側へ広がり、中央部が反対側へ寄る形は、正規分布よりも極端な値が出やすい、裾の厚い分布で見られます。
一方で、両端が内側に入り、中央部が反対側に膨らむ形は、正規分布より裾が短い分布を示すことがあります。
金融の収益率、アクセス数、故障までの時間などでは、正規分布よりも外側の値が多くなるケースがあります。
その場合、平均値を中心にした通常の推定だけでは、まれな事象の影響を小さく見積もるおそれがあります。
S字型のずれは、単なる描画上の乱れではなく、分布の裾に関する情報を含んでいます。
端の点ほど正規分布から大きく離れるなら、極端値の発生しやすさを別途検討するとよいでしょう。
片側だけ曲がるパターン
右側だけ大きく上へ曲がる、または左側だけ大きく下へ曲がる場合には、分布の左右非対称性である歪度が考えられます。
売上金額、待ち時間、所得、アクセス数のように、少数の大きな値が発生しやすいデータは右に長い裾を持ちやすい傾向があります。
逆に、上限が決まっている評価点や満足度スコアでは、左側に偏ることもあります。
このような偏りがある場合は、対数変換、平方根変換、Box Cox変換などを検討する余地があります。
ただし、変換は正規性を整えるためだけに機械的に選ぶものではありません。
変換後の値が業務上どのような意味を持つのか、結果を説明できるかまで考慮しましょう。
| 点列の形 | 考えられる特徴 | 確認したい事項 |
|---|---|---|
| ほぼ直線 | 正規分布に近い形 | 端部に大きな逸脱がないか |
| S字型 | 裾の厚さが正規分布と異なる | 極端値の頻度と影響 |
| 右側で上に曲がる | 右に長い裾、正の歪み | 大きな値の原因と変換の必要性 |
| 左側で下に曲がる | 左に長い裾、負の歪み | 下限付近への集中 |
| 一点だけ離れる | 外れ値または入力ミス | 元データと測定条件 |
外れ値とデータの偏りの確認
続いては外れ値とデータの偏りを、q-qプロットで確認する方法を解説していきます。
外れ値として現れる点の特徴
大多数の点が参照線に沿っているにもかかわらず、一部の点だけが大きく離れている場合は、外れ値の可能性があります。
外れ値は必ずしも削除すべき値ではありません。
測定ミス、入力ミス、機器異常による値であれば修正や除外を検討できますが、実際に起きた重要な事象であれば分析対象として残す必要があります。
たとえば製造工程の異常、顧客の高額購買、治療後の急激な変化は、外れ値であると同時に見逃せない情報かもしれません。
外れ値を見つけることと、外れ値を消すことは別の作業です。
q-qプロットで気になる点を見つけたら、元の観測記録、日時、担当者、条件などに戻って原因を確かめることが基本になります。
複数の集団が混ざる場合
q-qプロットが滑らかな曲線ではなく、途中で折れ曲がったように見える場合には、異なる集団が混在していることがあります。
たとえば昼勤と夜勤で工程のばらつきが異なる場合や、新旧の設備で性能差がある場合、全体を一括して分析すると分布が単純な正規形になりません。
この状態で平均値や標準偏差だけを報告すると、どちらの集団にも当てはまりにくい代表値になる可能性があります。
属性別、期間別、設備別、地域別などに分けてq-qプロットを作ると、問題の所在が見えやすくなるでしょう。
全体のq-qプロットが大きく曲がっていても、グループ別に分けると各群は直線に近くなることがあります。
分布の問題に見える現象が、実際には集団の混合によって起きている場合もあります。
ヒストグラムや箱ひげ図との併用
q-qプロットは強力な図ですが、一枚だけで結論を急ぐべきではありません。
ヒストグラムではデータの山の数やおおまかな広がりをつかめます。
箱ひげ図では中央値、四分位範囲、外れ値候補を簡潔に比較できます。
さらに、平均値、中央値、標準偏差、歪度、尖度といった記述統計量を併せて確認すると、分布の理解が深まります。
平均値と中央値が大きく異なる場合は、左右の偏りがある可能性を考えられます。
複数の視点を組み合わせることで、グラフの印象に引きずられない判断につながります。
統計解析での活用と注意点
続いては統計解析でのq-qプロットの活用場面と、判断時の注意点を確認していきます。
回帰分析における残差の確認
回帰分析では、目的変数そのものではなく、残差の正規性を確認することが重要になる場面があります。
残差とは、モデルが予測した値と実際の値との差です。
説明変数と目的変数の関係を回帰式で表しても、残差に強い偏りや外れ値があれば、推定結果の解釈に影響することがあります。
残差のq-qプロットが大きく曲がる場合は、非線形の関係、分散の不均一、説明変数の不足、外れ値などを確認するきっかけになります。
ただし、q-qプロットだけで回帰モデルの良し悪しを判断することはできません。
残差対予測値プロットや影響度指標などと合わせて、総合的に診断しましょう。
正規性検定との使い分け
Shapiro Wilk検定、Kolmogorov Smirnov検定、Anderson Darling検定などは、正規性を数値で評価する代表的な方法です。
これらの検定はp値を示してくれるため、判断基準を定めやすい利点があります。
一方で、標本数が非常に多いと実務上は小さな差でも有意になりやすく、正規性からの逸脱が検出されることがあります。
反対に標本数が少ない場合は、明らかな偏りがあっても検定で検出できないことがあります。
そのため、検定結果だけでなくq-qプロットの形も確認する使い方が有効です。
p値が基準を満たしたからといって、データが完全な正規分布であると証明されたわけではありません。
検定とグラフを併用し、分析の目的に対して問題となる逸脱かどうかを判断することが重要です。
標本数による見え方の違い
標本数が少ないq-qプロットでは、点が粗く、偶然のばらつきが目立ちます。
10件から20件程度のデータであれば、多少の波打ちがあっても自然な揺れの範囲かもしれません。
標本数が増えると点列の傾向は読み取りやすくなりますが、微小なずれも目につきます。
このため、データ数が多いほど厳しい基準で正規性を否定するのではなく、ずれが分析結果に与える実質的な影響を考えることが必要です。
統計的な有意性と実務上の重要性は同じではありません。
分析の目的、意思決定のリスク、代替手法の有無を踏まえて、適切な対応を選びましょう。
q-qプロットを読むときの実践手順
続いてはq-qプロットを実務で読むときの実践手順を確認していきます。
基準線と軸の内容を確認する手順
最初に、グラフの軸が理論分位点と標本分位点のどちらを示すかを確認します。
次に、描かれている線がどのような方法で引かれた参照線なのかを把握しましょう。
平均値と標準偏差を使う線、四分位点を基準にする線など、作図方法によって線の位置がわずかに異なる場合があります。
その後、中央部、下側の端部、上側の端部を順に見て、点のずれが偶然の範囲か、一定方向の曲がりかを確認します。
一点だけ離れているなら個別の記録を調べ、複数の点が連続して離れているなら分布全体の特徴を考える流れがわかりやすいでしょう。
判断を記録する書き方
分析報告では、正規性がある、ないと短く書くだけでは情報が不足しがちです。
たとえば、中央部は参照線に沿う一方で上側の裾に軽い逸脱が見られた、というように、ずれの位置と程度を記録すると内容が伝わります。
外れ値候補が見つかった場合には、確認した結果と、その値を残した理由または除外した理由も記載するとよいでしょう。
グラフを共有する際は、対象件数、対象期間、単位、除外条件を近くに示すことで、受け手が誤解しにくくなります。
判断の根拠を文章として残すことが、後から分析を見直す際にも役立ちます。
正規分布に合わない場合の対応
q-qプロットで明確な非正規性が見られた場合でも、すぐに分析を中止する必要はありません。
まずは入力ミス、測定条件の違い、複数集団の混合、外れ値の原因を確認します。
その上で、対数変換などのデータ変換、ノンパラメトリック検定、ロバスト推定、一般化線形モデルといった方法を検討できます。
順位に基づくMann WhitneyのU検定やKruskal Wallis検定は、正規性を強く前提としない比較方法として知られています。
どの手法が適切かは、データの尺度、標本数、比較したい内容、結果の利用目的によって変わります。
正規分布に当てはまらないことを失敗と捉えるのではなく、データの性質に合う分析方法を選ぶための情報として扱うことが大切です。
q-qプロットのまとめ
q-qプロットとは、観測データの分位点と正規分布などの理論分布の分位点を比較し、分布の形を視覚的に確認するためのグラフです。
点が参照線におおむね沿っていれば正規分布に近いと考えられ、S字型の曲がり、片側への偏り、孤立した点があれば、裾の違い、歪み、外れ値などを検討するきっかけになります。
判断では、基準線への完全な一致を求めるのではなく、ずれ方に一貫した傾向があるかを確認しましょう。
また、ヒストグラム、箱ひげ図、正規性検定、記述統計量と組み合わせれば、より確かな分析につながります。
q-qプロットはデータの特徴を対話的に読み解くための入口です。
正規分布との比較結果を次の分析手法の選択へ活かし、目的に合った統計解析を進めていきましょう。