
検出力とサンプルサイズの関係は?必要な例数と計算の考え方を解説!(サンプルサイズ計算・例数設計・効果量)
統計解析を使った調査や臨床研究、Web施策の効果検証では、何人分のデータを集めるべきかが重要な論点になります。
例数が少なすぎれば、本当に差があっても見落とすおそれがあります。
反対に必要以上のサンプルを集めると、費用、期間、参加者の負担が増えてしまうでしょう。
そこで役立つのが、検出力、サンプルサイズ、効果量の関係を整理する考え方です。
この記事では、必要な例数を見積もる基本式から、実務での設計手順、よくある誤解までを分かりやすく解説します。
検出力とサンプルサイズの関係
それではまず検出力とサンプルサイズの関係について解説していきます。
検出力が示す見つけやすさ
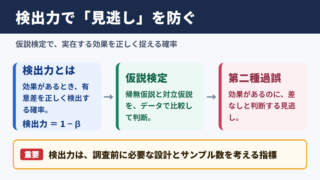
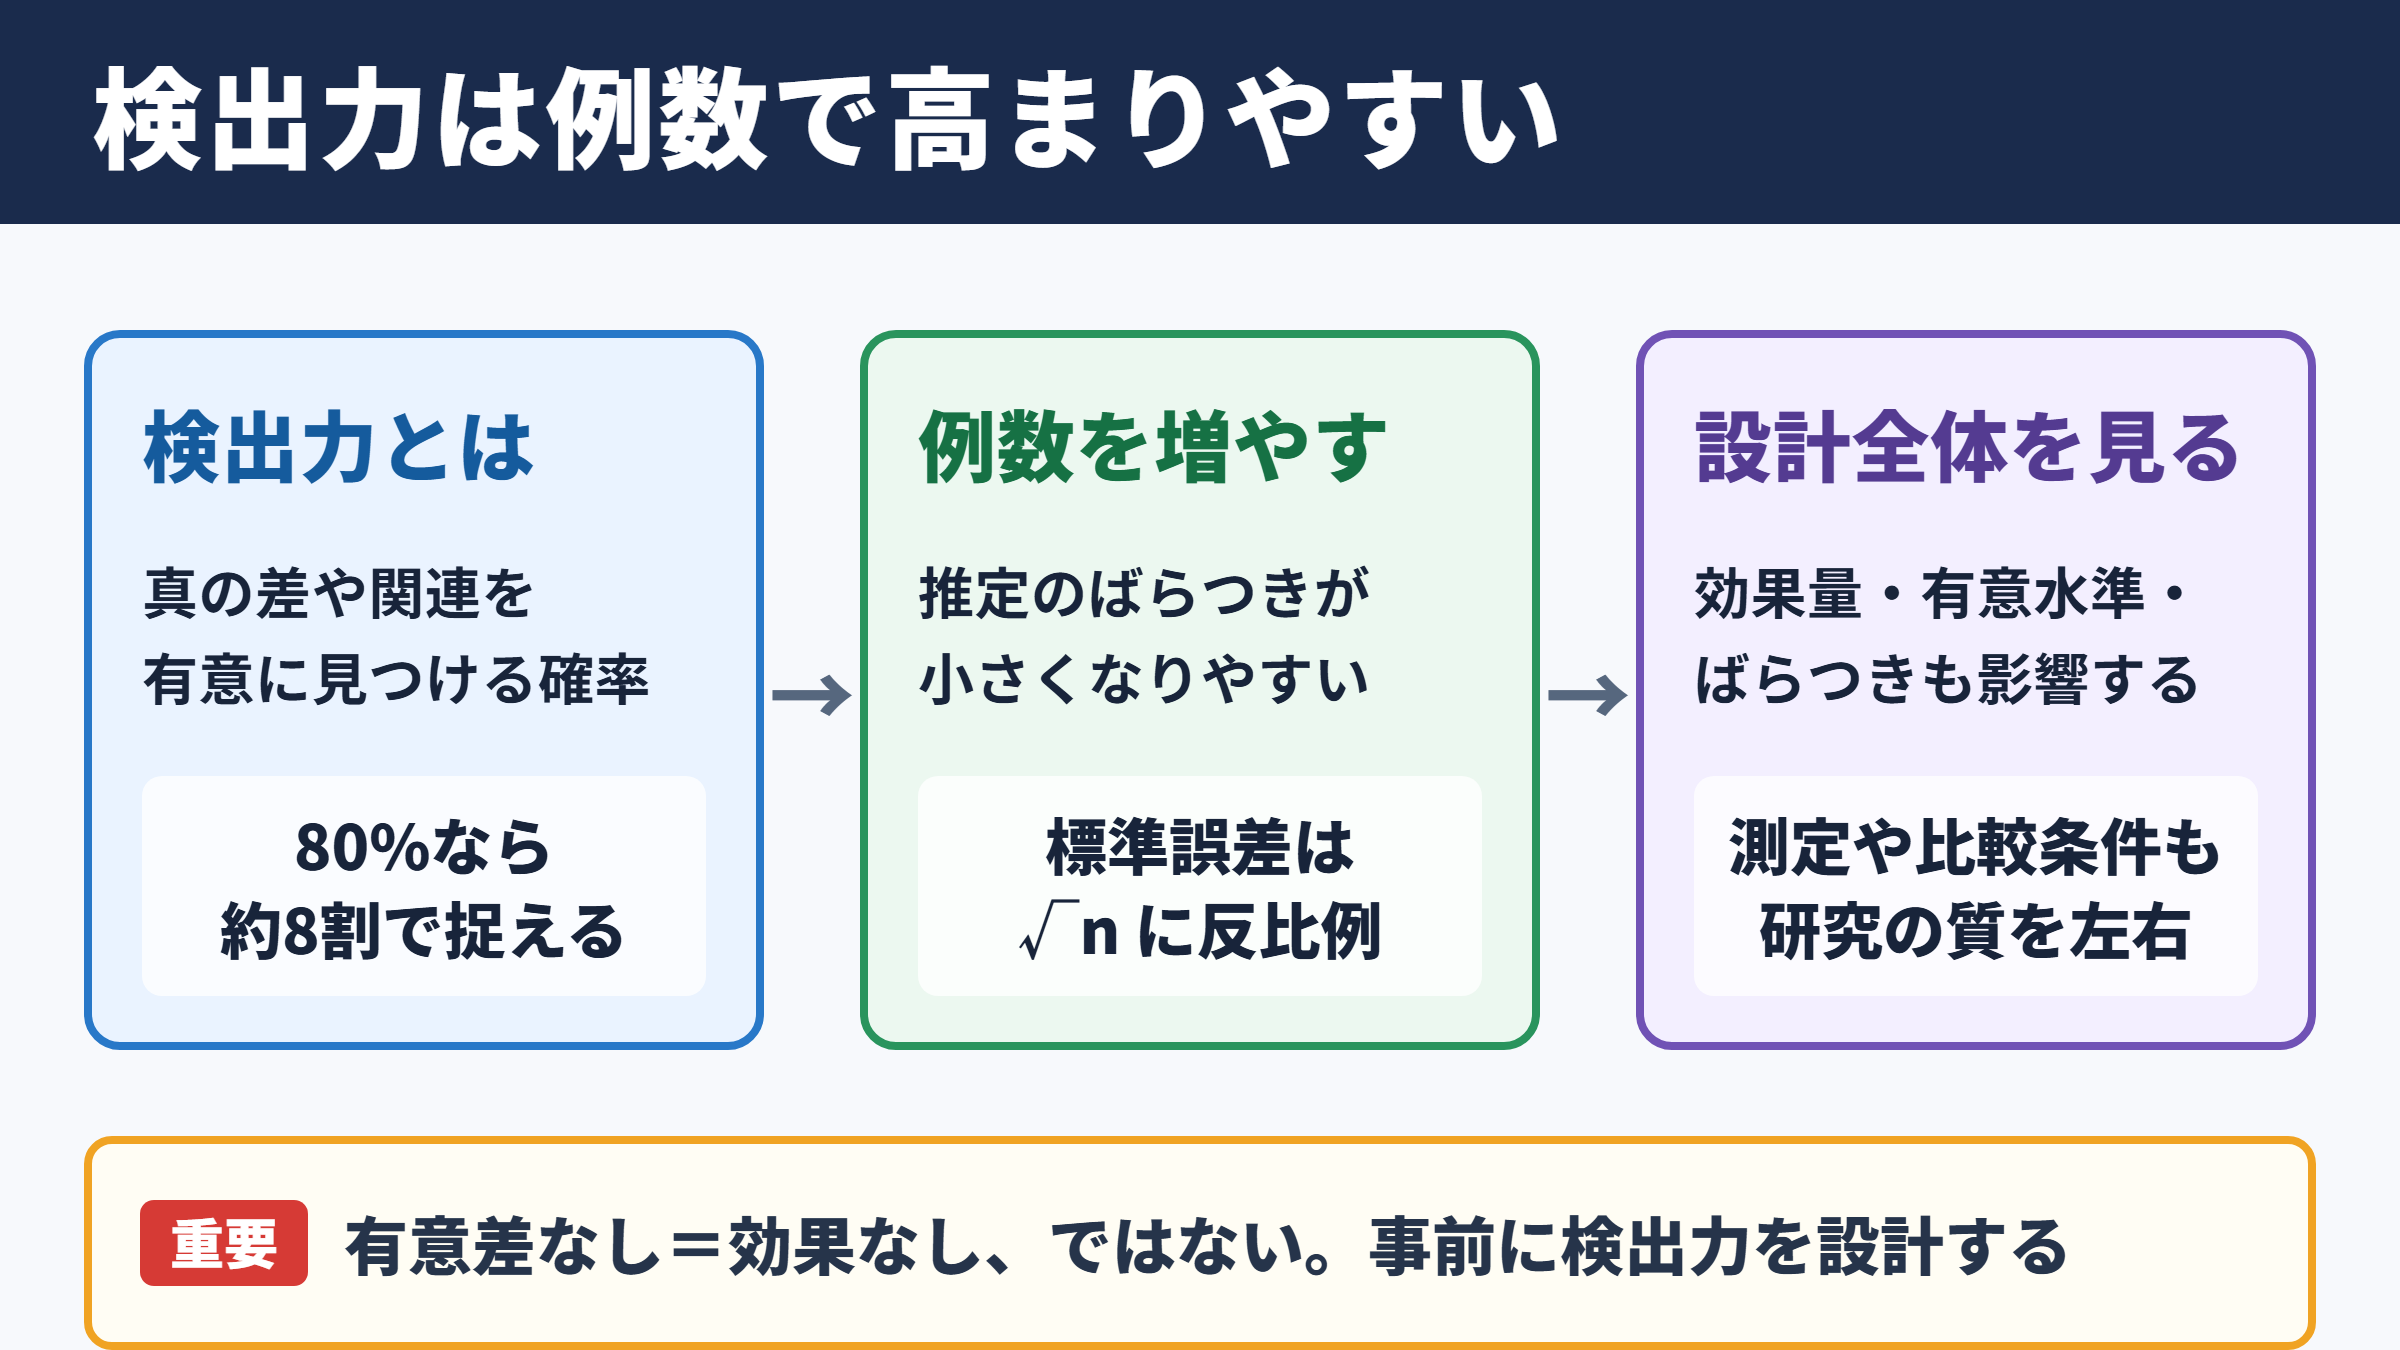
検出力とは、実際に差や関連が存在するとき、それを統計的に有意な結果として検出できる確率のことです。
一般にはパワーとも呼ばれ、0から1まで、または百分率で表します。
検出力80パーセントであれば、同じ条件の研究を繰り返した場合に、真の効果を約80パーセントの確率で捉えられるという意味になります。
検出力が低い研究では、効果があるにもかかわらず有意差なしという結論になりやすくなります。
この見落としは第二種の誤りと呼ばれます。
有意差が出なかったことと、効果が存在しないことは同じではありません。
その違いを理解するには、検出力を事前に設計へ組み込む必要があります。
サンプルサイズが増える効果
サンプルサイズは、分析に含める観測数、対象者数、標本数を指します。
ほかの条件が同じなら、例数を増やすほど推定値のばらつきは小さくなり、真の差を識別しやすくなります。
平均値の比較では、標準誤差は概ねサンプルサイズの平方根に反比例します。
つまり、ばらつきを半分程度にしたい場合、単純に例数を2倍にするだけでは足りません。
おおむね4倍の観測数が必要になる場面もあります。
標準誤差の考え方
標準誤差は、標準偏差をサンプルサイズの平方根で割った値として捉えられます。
サンプルサイズが大きいほど、平均や割合の推定は安定しやすくなります。
ただし、例数だけを増やしても、測定が不正確だったり、比較群の条件が大きく違ったりすれば、研究の質は高まりません。
検出力を左右する四つの要素
検出力は、サンプルサイズだけで決まるものではありません。
主な要素は、効果量、有意水準、データのばらつき、検定方法です。
| 要素 | 検出力への影響 | 設計時の見方 |
|---|---|---|
| サンプルサイズ | 多いほど高まりやすい | 脱落分も含めて設定する |
| 効果量 | 大きいほど検出しやすい | 実務上意味のある差を定める |
| 有意水準 | 厳しくすると低下しやすい | 通常は5パーセントを基準にする |
| ばらつき | 大きいほど低下しやすい | 先行研究や予備調査で確認する |
| 片側か両側か | 両側検定は必要例数が増えやすい | 仮説設定の段階で決める |
これらは相互に関係するため、例数だけを切り離して考えるのは適切ではありません。
サンプルサイズ計算の基本要素
続いてはサンプルサイズ計算の基本要素を確認していきます。
有意水準と第一種の誤り
有意水準は、実際には差がないのに差があると判定してしまう確率の上限です。
一般的には5パーセントが用いられ、記号ではアルファで表現されます。
有意水準を1パーセントに下げると、偶然の差を効果と誤認する危険は抑えられます。
一方で、判定基準が厳しくなるため、同じ検出力を維持するにはより多くの例数が必要です。
有意水準を厳しくする判断には、必要例数の増加という代償があります。
複数の評価項目を同時に検定する研究では、多重比較への対応も考慮しなければなりません。
第二種の誤りと目標検出力
第二種の誤りは、実際には効果があるのに、効果なしと判断する誤りです。
この確率はベータで表され、検出力は1からベータを引いた値になります。
目標検出力としては80パーセントが広く使われます。
より重要な意思決定を伴う臨床試験や安全性評価では、90パーセントを目標にすることもあります。
高い検出力は望ましい一方、必要な参加者数は増えます。
予算や募集可能人数だけで決めるのではなく、見落とした場合の影響も含めて目標値を選ぶ姿勢が大切でしょう。
片側検定と両側検定の違い
片側検定は、効果の方向をあらかじめ一方向に限定して検討する方法です。
たとえば、新しい施策が既存施策より改善する場合だけを問題にする設計が該当します。
両側検定は、改善と悪化のどちらも検出対象にします。
通常の研究や比較試験では、予想外の悪化も重要な情報になるため、両側検定が選ばれることが多いでしょう。
片側検定は、例数を少なく見積もれるからという理由だけで選ぶものではありません。
反対方向の結果を研究上の意思決定から除外できる、明確な根拠がある場合に限って検討します。
分析開始後に都合よく検定方法を変えると、結論の信頼性が損なわれます。
効果量による必要例数の見積もり
続いては効果量による必要例数の見積もりを確認していきます。
効果量の意味と実務上の重要性
効果量は、差や関連の大きさを標準化して示す指標です。
単に有意かどうかではなく、その差がどれほど意味を持つのかを評価するために使われます。
サンプルサイズが非常に大きいと、ごく小さな差でも有意になり得ます。
逆に、少人数では実務的に重要な差でも有意にならないことがあります。
例数設計では、統計的有意性より前に、検出したい最小限の意味ある差を決めることが重要です。
この考え方は最小臨床的重要差、最小検出可能効果などの名称で扱われます。
平均値比較における標準化効果量
二つの群の平均を比べる場合には、Cohenのdがよく使われます。
これは二群の平均差を標準偏差で割った値です。
標準化平均差の例
Cohenのdは、二群の平均差を共通の標準偏差で割って求めます。
平均差が5、標準偏差が10であれば、効果量は0.5です。
慣例として、dが0.2程度は小さい差、0.5程度は中程度の差、0.8程度は大きい差と紹介されることがあります。
ただし、これらは万能の基準ではありません。
医療、教育、製造、マーケティングでは、同じ数値でも意思決定上の重みが異なります。
先行研究の分布、顧客価値、コスト、リスクを踏まえて効果量を定めましょう。
割合比較と相関分析の効果量
コンバージョン率や不良率のような割合を比べる場合、重要になるのは二群の割合差です。
たとえば購入率が10パーセントから12パーセントに上がる差は、絶対差では2ポイントです。
相対的には20パーセント増加となるため、どちらの見方を採用するかで印象が変わります。
相関分析では、相関係数そのものを効果の大きさとして扱います。
小さな相関を安定して検出するには、多くの観測数が必要になります。
| 分析の目的 | 代表的な効果量 | 必要例数を左右する点 |
|---|---|---|
| 二群の平均比較 | Cohenのd | 平均差と標準偏差の比 |
| 対応のある平均比較 | 対応差の標準化値 | 同一対象内の変化のばらつき |
| 二群の割合比較 | 割合差、オッズ比 | 基準となる発生率 |
| 相関分析 | 相関係数r | 小さい相関ほど多数の観測が必要 |
| 回帰分析 | 決定係数、回帰係数 | 説明変数の数や欠測率も影響 |
例数設計の手順と計算方法
続いては例数設計の手順と計算方法を確認していきます。
主要評価項目の明確化
サンプルサイズ計算は、何を主要な評価項目にするかを決めるところから始まります。
複数の指標を測定する場合でも、研究の成否を判断する中心指標を明確にする必要があります。
主要評価項目が曖昧なまま例数を算出すると、途中で都合のよい結果だけを選ぶ余地が生まれます。
たとえば、新しい学習教材を評価するなら、得点、継続率、満足度のうち、どれを主な判断材料にするのかを事前に定めます。
必要例数は、最も重要な仮説を検証するために計算するのが基本です。
副次的な分析は探索的な位置づけにし、過度な結論を避けるとよいでしょう。
計算に必要な入力値
計算ツールや統計ソフトに入力する値は、分析の種類によって異なります。
しかし、多くのケースで必要になる情報には共通点があります。
二群比較で確認する主な入力値
有意水準、目標検出力、効果量、片側か両側か、群間の割付比を設定します。
連続値を扱う場合は標準偏差、割合を扱う場合は各群の想定割合も必要です。
入力値の根拠には、過去の実績データ、信頼できる先行研究、予備調査、専門家との合意などを用います。
根拠のない楽観的な効果量を置くと、必要例数を少なく見積もってしまいます。
反対に極端に小さい効果だけを想定すると、現実的でない規模になることもあります。
簡易計算の考え方
二群の平均を同じ人数で比較する場合、必要例数は効果量の二乗におおむね反比例します。
効果量が半分になれば、必要な人数は約4倍になるという関係です。
有意水準5パーセント、両側検定、検出力80パーセントという典型条件では、効果量dが0.5程度なら一群あたり60人台が目安になることがあります。
ただし、これは単純化した目安にすぎません。
不均等割付、繰り返し測定、共変量調整、クラスター構造がある場合は、そのまま当てはめられません。
サンプルサイズ計算の結果は、正確な人数を保証する数字ではなく、仮定に基づく設計値です。
どの効果量、ばらつき、脱落率を前提にしたのかを記録しておくことが欠かせません。
研究デザイン別の例数調整
続いては研究デザイン別の例数調整を確認していきます。
脱落率と欠測値への対応
計算で求めた人数は、解析まで完了する対象数を意味することが多いでしょう。
実際の調査では、途中離脱、回答漏れ、測定不能、除外基準への該当などが起こります。
そのため、募集人数は必要解析数より多く設定します。
解析に各群100人が必要で、脱落率を15パーセントと見込むなら、100を0.85で割る考え方を使います。
この場合は一群あたり約118人を募集する計画が必要です。
脱落分を後から補う計画ではなく、設計段階で上乗せしておくことが実務的です。
欠測の発生理由によっては、人数を増やすだけでは偏りを解消できない点にも注意しましょう。
クラスター化とデザイン効果
学校単位、店舗単位、病院単位のように、まとまりごとに対象を割り付ける研究をクラスター研究と呼びます。
同じクラスター内の対象者は、環境や担当者の影響を共有しやすいため、完全に独立したデータとは言えません。
この類似性を無視すると、見かけ上の例数を過大評価してしまいます。
そこで、クラスター内相関係数と一クラスターあたりの人数を使い、デザイン効果で必要数を調整します。
デザイン効果の基本的な考え方
デザイン効果は、1にクラスター内人数から1を引いた値と、クラスター内相関係数の積を加えた値です。
この値が1.5なら、単純無作為抽出で必要な例数の約1.5倍を目安にします。
クラスター数が少ない場合は、個人数だけを増やしても精度が十分に改善しないことがあります。
多変量解析と説明変数の数
回帰分析や機械学習を用いる研究では、説明変数の数も例数設計に関わります。
説明変数が多いほど、モデルは複雑になり、過学習や推定の不安定さが起こりやすくなります。
とくにロジスティック回帰では、対象者総数だけでなく、イベント数、つまり発生件数を確認することが重要です。
まれな事象を予測したい場合、全体人数が多くても発生件数が不足することがあります。
多変量解析では、総サンプル数とイベント数の両方を見て設計します。
変数選択を後付けで繰り返すより、研究目的に沿って少数の重要変数をあらかじめ選ぶほうが安定した分析につながります。
検出力設計における注意点
続いては検出力設計における注意点を確認していきます。
事後検出力だけに頼らない姿勢
分析後に得られたp値や観測された効果量を使い、事後的な検出力を計算することがあります。
しかし、事後検出力は得られたp値と強く連動しやすく、新しい判断材料になりにくい場合があります。
有意差がなかった結果を説明するためだけに低い事後検出力を示しても、研究の限界を十分に整理できるとは限りません。
大切なのは、事前に想定した最小重要効果を検出できる設計だったかを確認することです。
結果の解釈では、効果量の推定値と信頼区間も合わせて示すとよいでしょう。
実現可能性とのバランス
統計的に望ましい必要例数が、必ずしも現実に集められる人数とは限りません。
希少疾患、限定地域の調査、高額な測定を伴う実験では、募集可能数に上限があります。
その場合は、効果量の設定を都合よく大きくするのではなく、研究目的やデザインを見直します。
測定精度を上げる、繰り返し測定を行う、共変量を活用する、複数施設で協力するなど、効率を改善する選択肢があります。
例数不足が見込まれるときは、検証的研究として断定的な結論を目指すのか、探索的研究として仮説を絞り込むのかを明確にします。
研究の位置づけを正しく示すことが、無理な解釈を防ぐ鍵になります。
再現性を高める記録
サンプルサイズ計算では、最終的な人数だけでなく、計算過程を残すことが重要です。
使用したソフトやツール、バージョン、検定方法、有意水準、目標検出力、想定効果量、標準偏差、脱落率を記録します。
これにより、共同研究者や査読者が設計の妥当性を確認しやすくなります。
再現可能な例数設計は、数字の根拠を第三者がたどれる状態です。
途中で前提条件を変更した場合も、変更理由と影響を残しておくと、研究全体の透明性が高まります。
検出力とサンプルサイズのまとめ
検出力とサンプルサイズは、効果量、有意水準、データのばらつき、研究デザインと結び付いています。
例数を多くすれば検出力は高まりやすいものの、費用や時間、参加者への負担も増えるため、単純に多ければよいわけではありません。
まずは検出したい最小限の意味ある効果を定め、その効果を捉えるための例数を計算することが基本です。
平均値、割合、相関、回帰など、分析方法に合った効果量を選び、先行研究や予備データから妥当な前提を置きましょう。
脱落率、欠測値、クラスター構造、多変量解析におけるイベント数も、実務では見落とせない要素です。
必要例数の数字だけを採用するのではなく、前提条件と計算根拠を記録することで、信頼できる例数設計につながります。
検出力を意識した計画は、結果が出てから理由を探す分析を減らし、調査や研究から得られる知見の価値を高めてくれるでしょう。