
検出力とは?統計における意味と仮説検定との関係をわかりやすく解説!(検出力分析・検出力関数・検出力曲線)
統計的な分析では、有意差が出たかどうかだけで結論を急ぐと、重要な変化を見落とすことがあります。
その見落としに深く関係する考え方が検出力です。
検出力は研究、品質管理、マーケティング施策、医療統計、WebサイトのABテストなど、データを根拠に判断する幅広い場面で役立ちます。
本記事では、検出力の意味から仮説検定との関係、検出力分析の進め方、検出力関数と検出力曲線の読み方まで、順を追って解説します。
検出力の意味と仮説検定の関係
それではまず、検出力の基本的な意味と、仮説検定で果たす役割について解説していきます。
検出力が示す確率
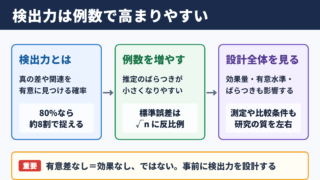
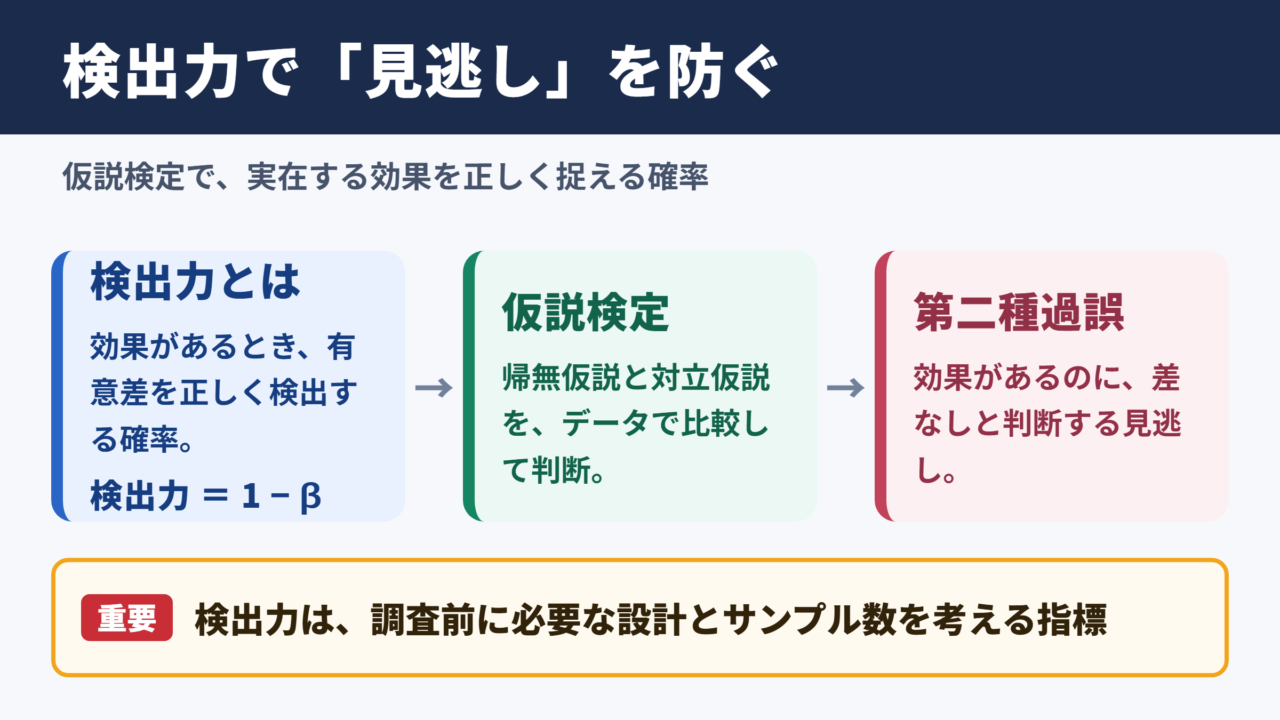
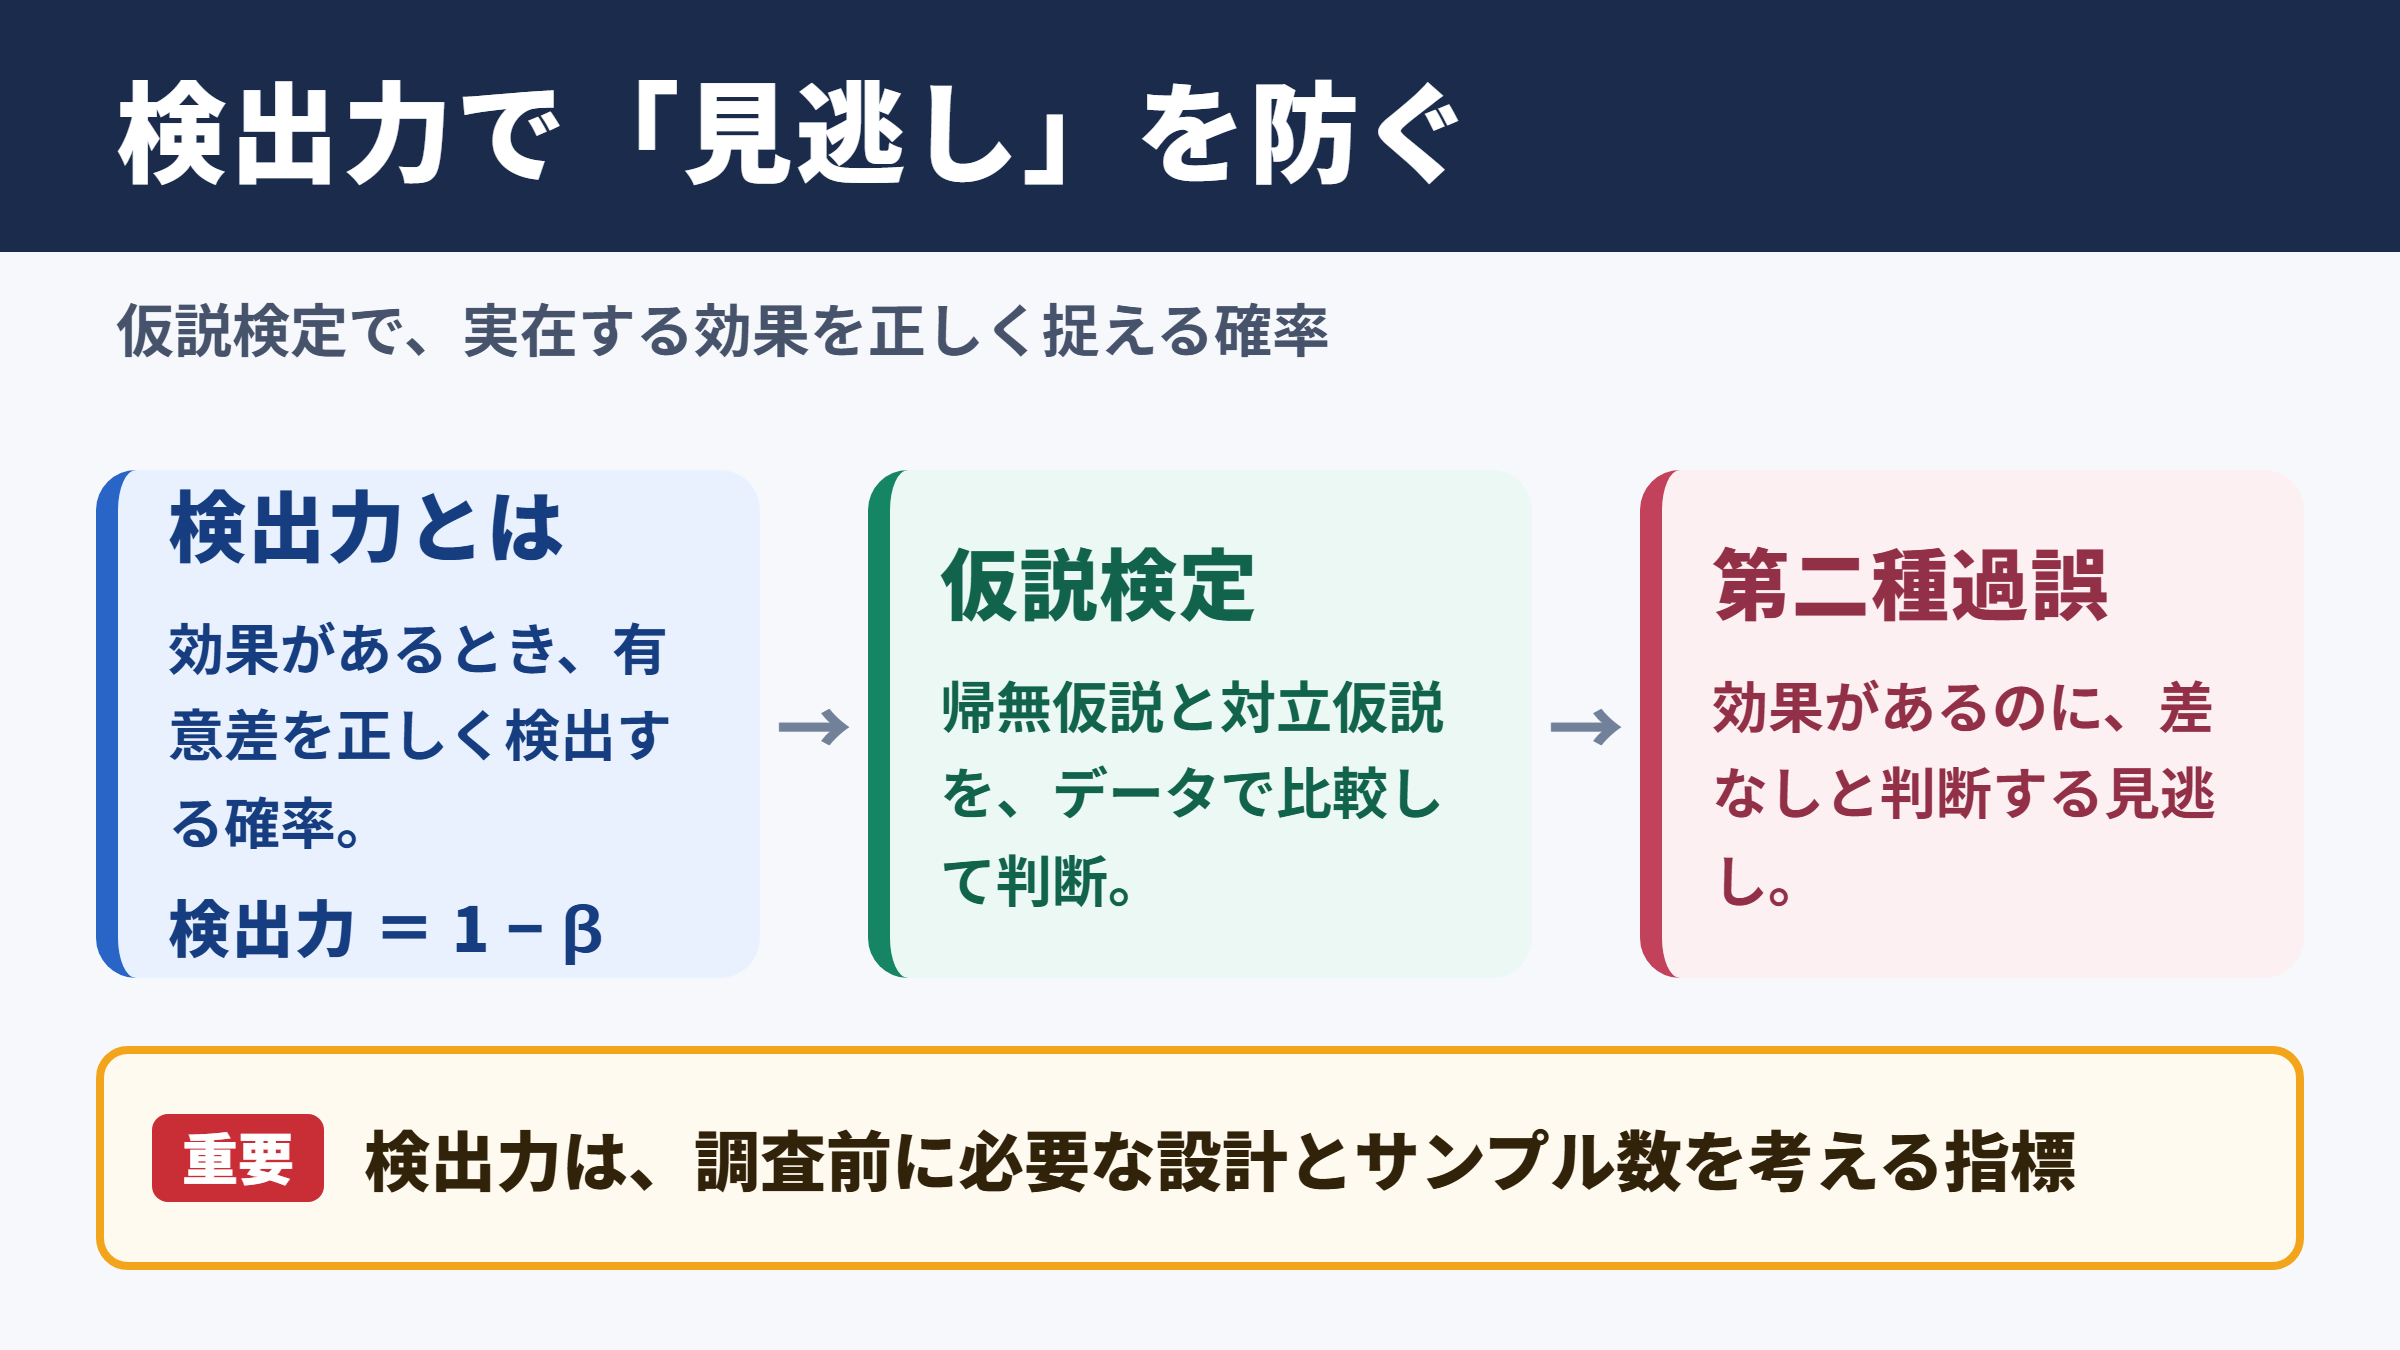
検出力とは、実際には差や効果が存在するときに、その差や効果を統計的に有意であると正しく検出できる確率のことです。
英語では statistical power と呼ばれ、一般に検出力は一から第二種過誤の確率を引いた値として表されます。
検出力 = 1 − β
βは第二種過誤が起こる確率を表します。
たとえば検出力が0.80なら、実際に意味のある効果がある場合、その効果を有意差として捉えられる確率は80パーセントという意味です。
反対に20パーセント程度は、効果が存在していても有意差なしと判断してしまう可能性があります。
検出力は、分析後の結果を都合よく解釈するための数字ではありません。
調査や実験を始める前に、必要なサンプル数や設計の妥当性を考えるための重要な指標です。
帰無仮説と対立仮説の位置づけ
仮説検定では、まず差がない、効果がないという帰無仮説を置きます。
そのうえで、差がある、効果があるという対立仮説と比べ、得られたデータが帰無仮説とどの程度矛盾するかを確認します。
たとえば新しい広告のクリック率を検証する場合、帰無仮説は新旧の広告に差がないことです。
対立仮説は、新しい広告によってクリック率が変化することになります。
p値が有意水準より小さければ帰無仮説を棄却し、有意差があると判断します。
ただし、p値が有意水準を上回ったからといって、差が絶対にないと証明されたわけではありません。
検出力が低い検定では、存在する差を見つけられないまま終わることがあるためです。
第一種過誤と第二種過誤の違い
仮説検定では、判断を誤る可能性を二種類に分けて考えます。
| 実際の状態 | 検定の判断 | 結果 |
|---|---|---|
| 差がない | 差があると判断 | 第一種過誤 |
| 差がある | 差がないと判断 | 第二種過誤 |
| 差がない | 差がないと判断 | 正しい判断 |
| 差がある | 差があると判断 | 正しい検出 |
第一種過誤は、本当は効果がないのに効果があると判断する誤りです。
その確率は有意水準αで管理し、0.05に設定されることがよくあります。
一方の第二種過誤は、本当は効果があるのに効果がないと判断する誤りです。
検出力は第二種過誤と表裏一体であり、βを小さくするほど高くなります。
有意水準だけを厳しく設定しても、良い検定設計になるとは限りません。
第一種過誤を抑えすぎると検出力が下がり、実務上意味のある差を見逃しやすくなるため、両者のバランスが必要です。
検出力を左右する四つの要素
続いては、検出力がどのような条件によって変わるのかを確認していきます。
サンプルサイズの影響
検出力を高める代表的な方法は、サンプルサイズを増やすことです。
対象者数、観測回数、購入データ数などが増えると、偶然によるばらつきの影響を小さくできます。
その結果、同じ程度の効果でも統計的に検出しやすくなります。
小規模な調査で有意差が出なかった場合、効果が存在しないのではなく、単にデータ数が不足している可能性もあります。
特に効果が小さいと予想されるテーマでは、十分なサンプルサイズの確保が欠かせません。
ただし、データを無制限に増やせばよいわけでもありません。
非常に大きな標本では、実務上ほとんど意味のない差でも有意になり得ます。
統計的有意性と実務的な重要性は別に評価する視点が大切です。
効果量の大きさ
効果量は、二つの群の差や変数間の関連の強さを、標準化して表した値です。
差が大きいほど検出しやすく、同じサンプルサイズでも検出力は高くなります。
平均値の差を扱うt検定では、Cohenのdがよく用いられます。
Cohenのd = 二群の平均値の差 ÷ 標準偏差
一般的な目安として0.2は小、0.5は中、0.8は大の効果量と説明されることがあります。
ただし、この目安をそのまま全分野へ当てはめるのは注意が必要です。
医療では小さな改善でも重要な意味を持つ場合があり、製造現場ではごく小さな誤差でも品質問題につながることがあります。
効果量は過去の研究、予備調査、事業上の目標を踏まえて設定するのが自然でしょう。
有意水準と片側検定
有意水準αを0.05から0.01へ下げると、偶然の差を有意と誤認するリスクは小さくなります。
その一方で、帰無仮説を棄却するための基準が厳しくなるため、検出力は低下します。
また、両側検定と片側検定でも検出力は異なります。
両側検定は、効果が増える方向と減る方向の両方を確認する方法です。
片側検定は、あらかじめ定めた一方向の変化だけを検証します。
| 項目 | 検出力への影響 | 考え方 |
|---|---|---|
| サンプルサイズの増加 | 高くなる | 推定の不確実性が小さくなる |
| 効果量の増加 | 高くなる | 群間の違いを見つけやすい |
| 有意水準の引き下げ | 低くなる | 有意判定の基準が厳しくなる |
| データのばらつきの増加 | 低くなる | 効果がノイズに埋もれやすい |
| 片側検定の採用 | 条件により高くなる | 方向を事前に合理的に限定できる場合のみ |
片側検定を結果を見てから選ぶことは、恣意的な判断につながります。
検定方向は、分析前に研究目的や仮説に基づいて決めておく必要があります。
検出力分析の進め方
続いては、調査や実験の設計時に行う検出力分析の基本的な流れを確認していきます。
事前分析と事後分析の違い
検出力分析には、事前に行う方法と分析後に確認する方法があります。
もっとも重要なのは、データ収集前に実施する事前の検出力分析です。
事前分析では、期待する効果量、有意水準、目標とする検出力を入力し、必要なサンプルサイズを求めます。
目標検出力には0.80や0.90が使われることが多くあります。
0.80は第二種過誤を20パーセント程度まで許容する設計であり、分野や研究の重要性によっては0.90以上を目指すこともあります。
事後分析は、実際のサンプルサイズや推定効果量を使い、実施済みの検定がどの程度の検出力だったかを確認するものです。
しかし、有意差が出なかった後に事後検出力だけを示しても、結果の解釈が大きく改善するとは限りません。
非有意結果を評価する際は、信頼区間や最小検出可能効果量も併せて見る方が有益です。
必要サンプル数の考え方
必要サンプル数は、検定の種類によって計算方法が変わります。
二群の平均を比較するt検定、割合を比較する検定、相関係数の検定、回帰分析、分散分析などでは、必要となる入力値が異なります。
二群比較では、各群の人数が均等である方が、合計人数が同じ場合に効率よく検出力を確保できます。
ただし、対照群と処置群の人数比を変える必要がある実務もあります。
費用、対象者の確保しやすさ、倫理面を考慮しながら配分を決めましょう。
検出力分析で主に設定する項目
検定の種類、効果量、有意水準α、目標検出力、群数、群ごとの割付比、予想される脱落率です。
たとえば脱落率が10パーセントと見込まれるなら、計算で得た必要人数よりも多めに募集する必要があります。
必要人数は分析に使える最終データ数を基準に考えることが実務上のポイントです。
ソフトウェアと入力値の確認
検出力分析には、統計ソフトウェアや専用の計算ツールを利用できます。
ただし、ツールに数値を入力するだけでは、適切な設計になるとはいえません。
効果量の根拠、検定方法、欠測データの扱い、複数比較の有無を先に整理することが必要です。
過去の論文に記載された効果量を使う場合は、対象集団や測定方法が自分の研究と近いかを確認します。
先行研究で極端に大きな効果が報告されていると、必要サンプル数を少なく見積もってしまうことがあります。
検出力分析は数字合わせではなく、研究目的を測定可能な設計へ翻訳する作業です。
期待効果を過大に置かず、実際に検出したい最小の差を明確にすることが、信頼できる計画につながります。
検出力関数と検出力曲線の読み方
続いては、検出力関数と検出力曲線が何を表し、どのように活用できるかを確認していきます。
検出力関数の基本
検出力関数とは、真のパラメータの値に応じて、検定が帰無仮説を棄却する確率がどのように変化するかを示す関数です。
たとえば真の平均差がゼロなら、帰無仮説が正しい状態なので、棄却確率は有意水準αに近くなります。
真の平均差がゼロから大きく離れるほど、対立仮説が正しい証拠を得やすくなり、検出力は高くなります。
検出力関数は、単一の検出力の数値では表せない、効果の大きさと検出可能性の関係を示します。
そのため、研究設計の感度をより立体的に理解したいときに役立ちます。
検出力曲線から分かること
検出力曲線は、横軸に効果量や真の差、縦軸に検出力を置いて描くグラフです。
曲線が急に立ち上がる設計では、ある程度の効果があれば高い確率で検出できます。
反対に曲線が緩やかな場合は、十分な効果があっても検出力が上がりにくい可能性があります。
複数のサンプルサイズで曲線を並べると、人数を増やすことでどの程度改善するかを視覚的に比べられます。
検出力曲線は、どの大きさの効果まで見逃したくないかを考える道具として有用です。
単に0.80を満たすかどうかではなく、事業や研究にとって重要な最小効果量を横軸上で確認するとよいでしょう。
最小検出可能効果量の活用
最小検出可能効果量は、設定したサンプルサイズと有意水準のもとで、目標検出力を達成できる最小の効果量です。
予算や期間の都合でサンプル数を先に固定しなければならない場合、この考え方が特に役立ちます。
たとえば収集可能なデータ数が限られているとき、どの程度の改善なら80パーセントの確率で検出できるかを計算できます。
その値が実務上重要な改善幅より大きければ、今の設計では小さな改善を見つけられないことになります。
| 確認したいこと | 役立つ見方 | 主な用途 |
|---|---|---|
| 必要な人数 | 目標検出力から逆算 | 実験や調査の事前計画 |
| 効果ごとの検出可能性 | 検出力曲線 | 設計の感度確認 |
| 固定人数で見つけられる最小差 | 最小検出可能効果量 | 予算制約下の判断 |
| 非有意結果の不確実性 | 信頼区間と併用 | 結果の慎重な解釈 |
検出力が不足する場面と対策
続いては、検出力が不足しやすい場面と、設計や分析で考えられる対策を確認していきます。
小標本による見逃し
対象者を集めにくい調査や、希少な事象を扱う研究では、十分な標本数を確保できないことがあります。
小標本では推定値のばらつきが大きくなり、信頼区間も広がりやすくなります。
その結果、有意差が出ないという結論だけが残り、本当に効果が小さいのか、データが足りないのかを区別しにくくなります。
このような場合は、事前に実現可能なサンプルサイズでの検出力曲線を作成し、検出できる効果の範囲を共有しておくとよいでしょう。
研究の限界を明確に記録することも、分析の信頼性を高める行動です。
ばらつきと測定誤差の管理
検出力はサンプルサイズだけで決まるものではありません。
測定値のばらつきが大きいと、本来の効果がノイズに埋もれ、検出力が下がります。
質問票の表現が曖昧である場合、測定機器の精度が不十分な場合、実験手順が担当者ごとに異なる場合などは、ばらつきが増える要因になります。
測定方法を標準化し、事前テストを行い、入力ミスや外れ値の扱いを事前に定めることが重要です。
データの品質改善は、人数を増やすのと同じくらい検出力に影響することがあります。
検出力不足への対策は、サンプル数の追加だけではありません。
測定精度の向上、不要なばらつきの削減、適切な共変量の利用、均等な群割付も有効な選択肢です。
複数比較と分析計画の重要性
一つのデータから多くの指標や群の組み合わせを検定すると、偶然に有意差が出る可能性が高まります。
これを抑えるために有意水準を調整すると、個々の検定に使える基準は厳しくなり、検出力は低下します。
複数比較が予定される研究では、主要評価項目を明確にし、補助的な探索分析と区別することが大切です。
必要に応じて補正方法を選び、その影響を含めてサンプルサイズを設計します。
分析計画を事前に定めることで、都合の良い結果だけを選ぶリスクも抑えられます。
検出力は計算結果の一項目ではなく、再現性のある分析を支える設計思想の一部と考えるとよいでしょう。
検出力の考え方のまとめ
検出力とは、実際に存在する差や効果を統計的に正しく検出できる確率です。
第二種過誤の確率βと関係し、検出力は一からβを引いた値として表されます。
検出力を左右する主な要素は、サンプルサイズ、効果量、有意水準、データのばらつきです。
有意差が出なかった結果を、効果がないという結論に直結させない姿勢も欠かせません。
検出力が十分でなければ、重要な差があっても見逃している可能性があります。
調査や実験の前に検出力分析を行い、必要サンプル数と検出したい最小効果量を決めることが、信頼できる仮説検定への第一歩です。
検出力関数や検出力曲線を使えば、設計がどの大きさの効果に反応できるかも具体的に把握できます。
有意水準、p値、効果量、信頼区間を組み合わせながら、統計的な結論と実務上の判断を丁寧につなげていきましょう。